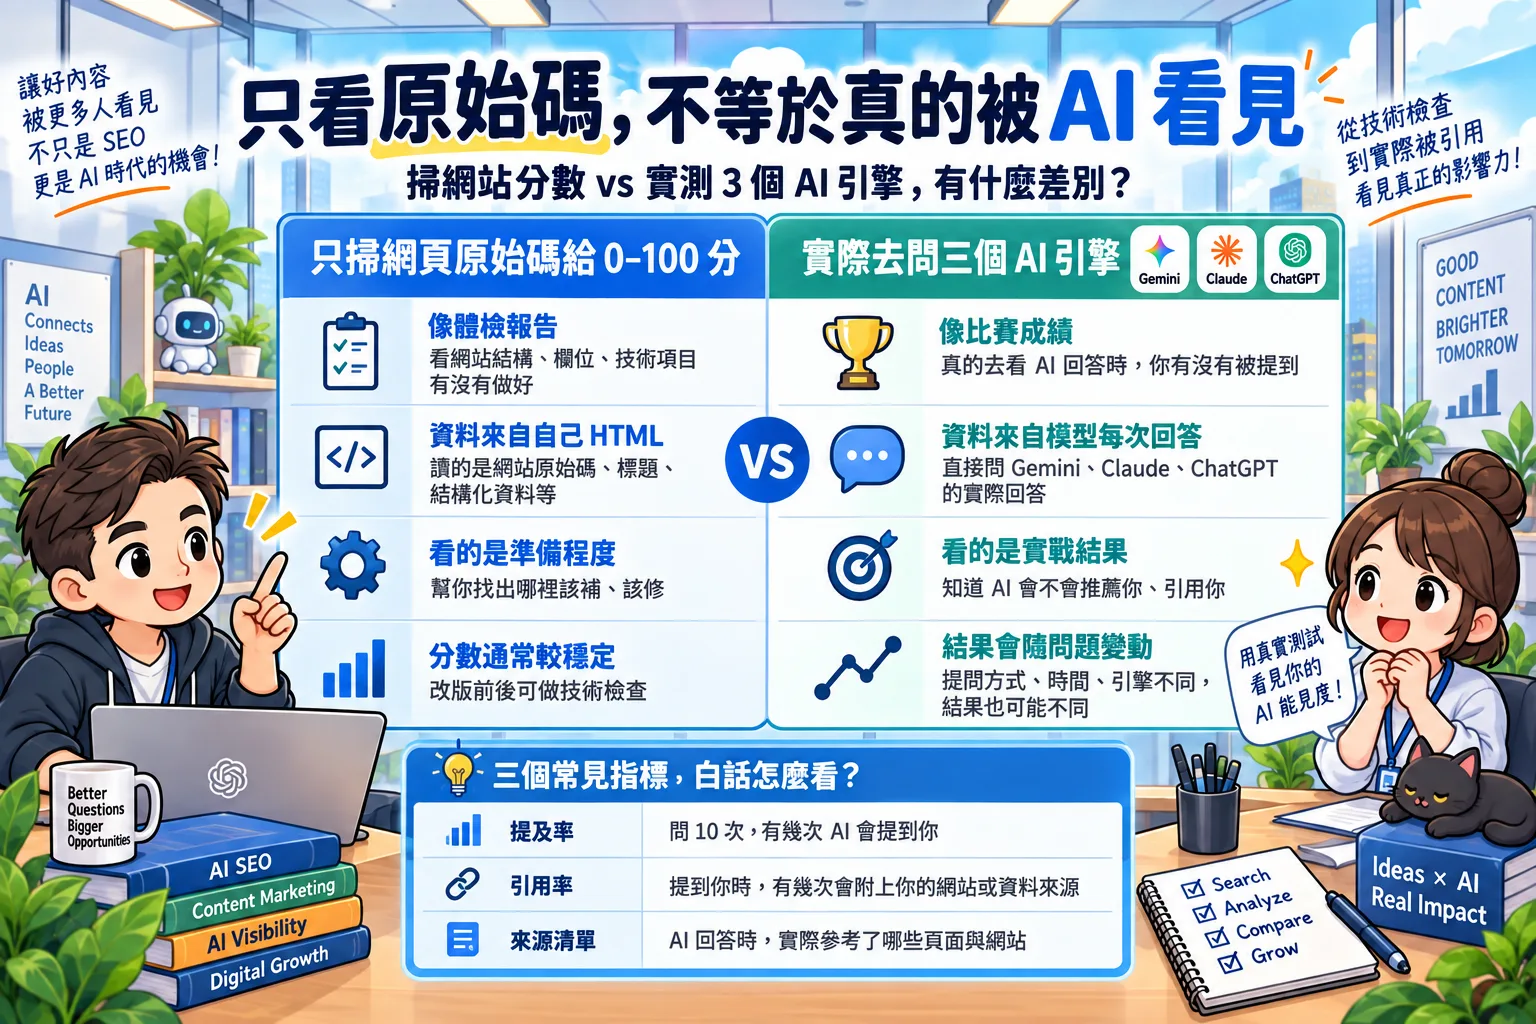
AI 能見度監測工具分兩種。一種只掃你的網頁原始碼,貼個網址就給你 0 到 100 分——那是 SEO 檢查表換個名字。另一種真的去問 ChatGPT、Claude、Gemini,看你的品牌有沒有被講出來、AI 又是從哪一頁讀到你。要選後者。
沒預算也能做:列 30 到 50 條台灣人真的會打的提示詞,每週固定跑一輪,用一張 Google Sheet 記下來。完整步驟在後面第八節。
先揭露立場:我們自己做了一套AI 能見度檢測工具,所以我有立場。但這篇裡每一道算式、每一個被我們拿掉的評分項目都寫出來,你可以自己複製一遍再決定信不信。另外,這篇的資料查證與初稿整理有 AI 協作,第一手數字與取捨判斷是我們自己跑出來的。
AI 能見度監測工具到底在量什麼?
AI 能見度監測工具是定期拿真人會打的問題去問 ChatGPT、Claude、Gemini,記錄三件事:你的品牌有沒有被講出來、出現在答案第幾句、AI 引用了哪些網頁。少了「去問」這個動作,量的就不是能見度。
| 只掃網頁原始碼給 0–100 分 | 實際去問三個 AI 引擎 |
|---|---|
| 像體檢報告:量你網站寫得好不好 | 像比賽成績:量 AI 講不講你 |
| 資料來自你自己的 HTML | 資料來自模型每一次的真實回答 |
| 分數變高不等於被提到 | 提及比例變高才是被提到 |
「被引用」要拆成兩件事分開記。一是答案的文字裡出現你的公司名,二是答案下方列出的來源網址有你的官網。只有前者,代表模型記得你;兩件都有,代表你的官網這次真的被讀進去了。
| 名詞 | 白話意思 |
|---|---|
| 提及率 | 同一題問 10 次,有幾次答案寫出你的品牌名 |
| 引用率 | 答案下方的來源網址,有幾次出現你的網域 |
| 來源清單 | AI 這次回答時實際讀了哪些網頁 |
現況是:搜尋第一頁好幾個免費「AI 能見度檢查」頁面,貼網址就給分數,沒有真的去問任何一個模型。
SEO 跟 GEO 差在哪?為什麼現在要分開看?
SEO 看你有沒有排在第一頁被點進來,GEO 看 AI 那段答案裡有沒有寫你的名字。這兩件事會脫鉤——自然排名前三,但 AI 答案引用的是你沒聽過的同業,排名沒掉,AI 就是沒讀你。
| 比較項目 | SEO | GEO |
|---|---|---|
| 看什麼 | 關鍵字排第幾名 | 答案裡有沒有提到你 |
| 資料從哪來 | Search Console 等搜尋後台 | 實際去問 AI 的逐次紀錄 |
| 要改的東西 | 頁面結構與別站有沒有連過來 | 可以被整段抄走的事實句 |
共用的地基只有一個:內容要寫成機器抓得走的段落,一段回答一個問題,數字與條件寫在同一句裡。
不要二選一。GEO 生成式引擎優化不是拿來取代SEO 搜尋優化的——官網如果連 Google 的資料庫都進不去,AI 也大多讀不到你。
怎麼選?先用這 6 題刷掉一半的工具
選 AI 能見度監測工具,用下面 6 題問供應商就夠了,答不出來的直接跳過。這張表也適合直接貼進你跟廠商的信裡。
| 要問的 6 題 | 及格的樣子 |
|---|---|
| 能不能自訂繁中提示詞庫 | 你能自己加「台中 網站設計 推薦」這種在地問法 |
| 測幾個引擎 | 寫明是哪幾個,而且每次都跑完,不是抽樣 |
| 同一題跑幾次 | 至少 3 次取比例,跑 1 次不算數據 |
| 報告有沒有列引用來源網址 | 看得到 AI 這次到底讀了哪些網頁 |
| 資料能不能匯出 CSV | 能自己做趨勢,換工具時不用從頭來過 |
| 綁不綁年約、資料歸誰 | 可月繳退場;合約寫明提示詞與品牌資料不會被拿去訓練 |
最後一題最多人忘記問。你送進去的提示詞其實就是你的客戶名單長相和報價痛點,值得在合約裡寫一行。我們自家的AI 雷達也是照這 6 題做的,所以我知道哪幾題會讓廠商停頓。
3 個引擎實測:同一批提示詞,來源清單差很多
我們只監測 ChatGPT、Claude、Gemini 三個引擎,不做 Perplexity 和 Grok。與其在文案上列五個名字然後抽樣跑,不如三個都真的每次跑完。
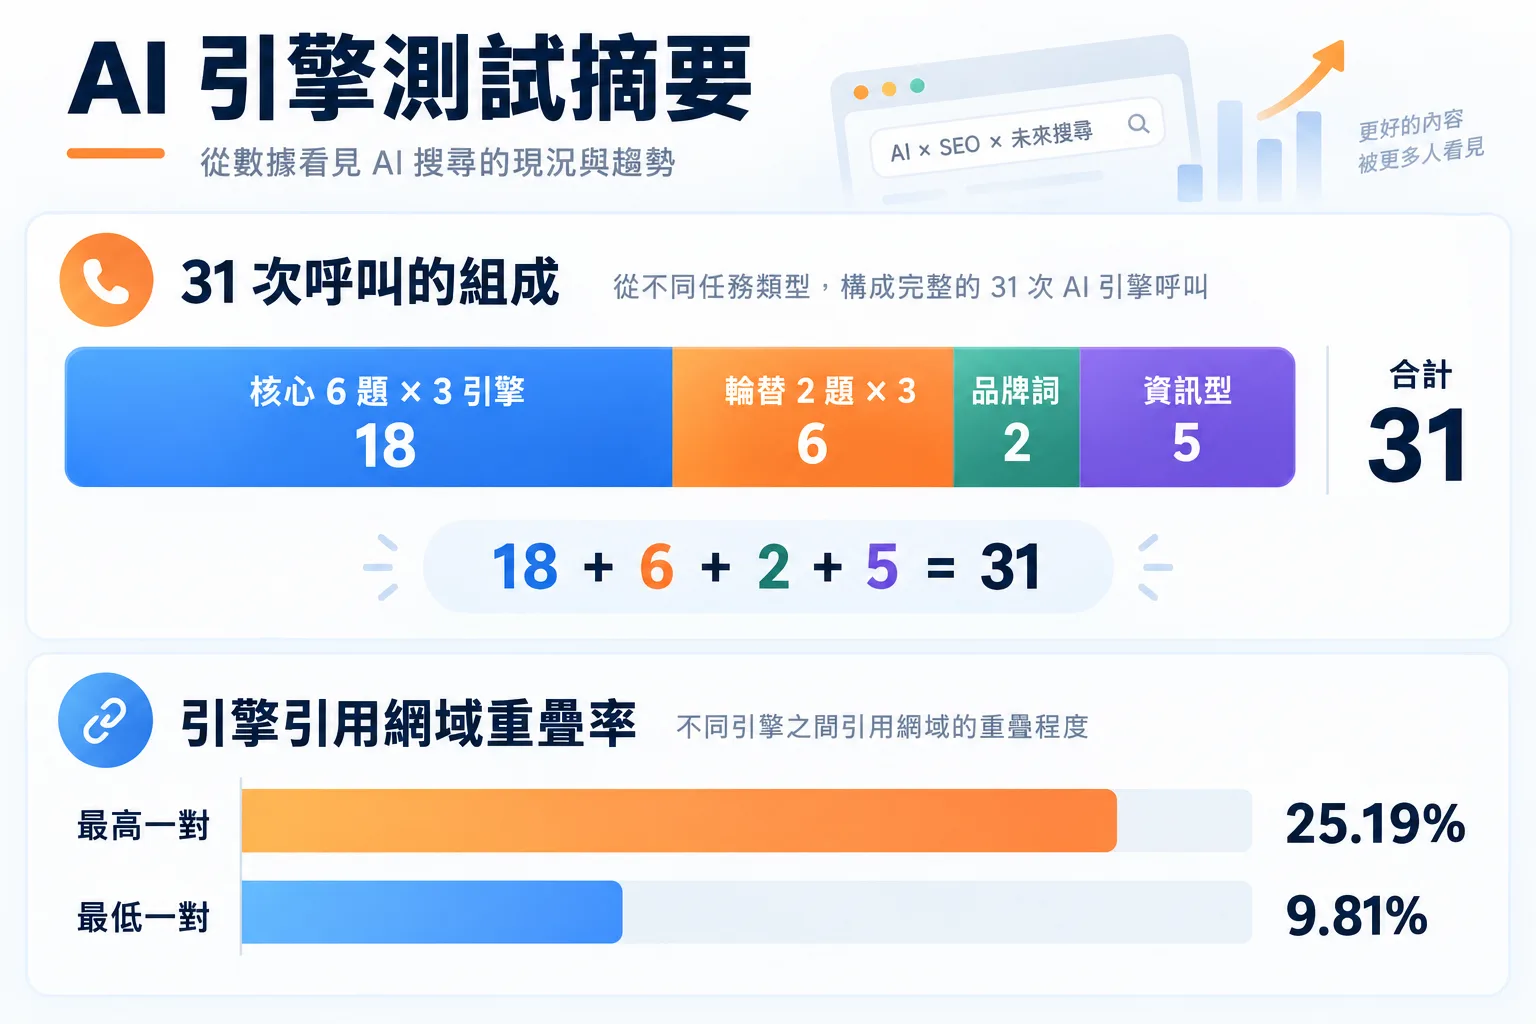
方法是固定的:同一批提示詞、同一組設定、同一個週期。掃一次要 30 到 60 秒,會產生 31 次 API 呼叫,算式列給你自己加:6 題核心 × 3 引擎 + 2 題輪替 × 3 + 品牌詞 2 + 資訊型 5,也就是 18+6+2+5=31。
最值得講的結果是引擎之間的落差。同一個網站,官網進得了其中一個引擎的來源清單,另一個引擎卻整頁都是論壇和新聞。所以我們不把三家合併成一張圖——合併會蓋掉最重要的訊息:你的官網到底打得到誰。順帶提一個外部的對照:SE Ranking 用同一組問題測過多家 AI 搜尋引擎,比對它們引用的網域,重疊率最高的一對(Perplexity 與 ChatGPT)也只有 25.19%,最低的一對(Bing Copilot 與 Google AI Overviews)只有 9.81%。所以「同一批提示詞、來源清單差很多」不是我們這輪的偶發現象,是引擎本來就長成這樣。(一個整理跨引擎引用研究的台灣 AI 行銷部落格(引述 SE Ranking 的測試),2026-09-22 查)
想先自己動手,可以照網站的 AI 能見度怎麼查那篇的 31 項自測走一遍。
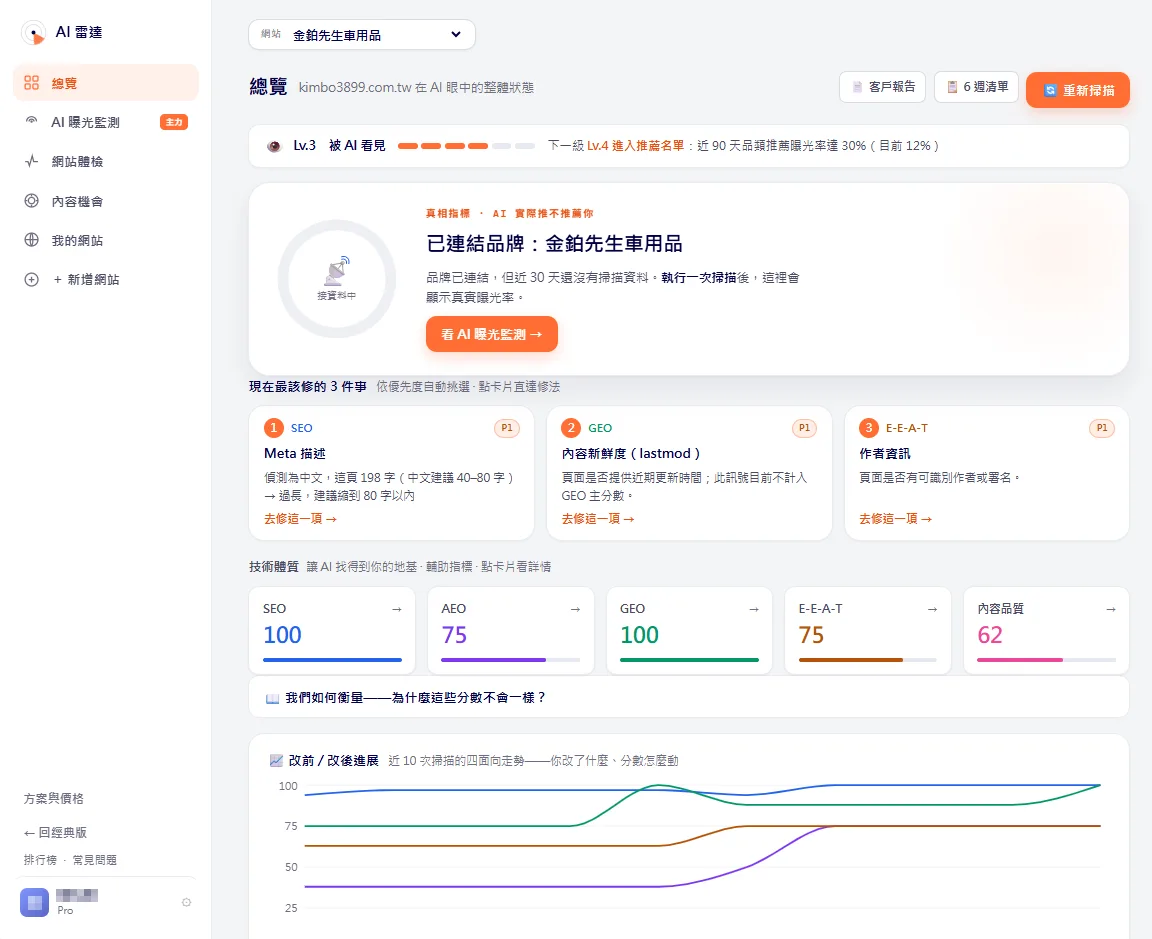
我們的工具長什麼樣?為什麼把 llms.txt 和 Twitter Card 拿掉
我們的 GEO 計分表這一年拿掉了兩個項目,分母從 9 一路降到 7。先說性質:以下都是用我們自己的工具量的,不是業界評比,也不是公開數據——我用我的尺量了一次,尺長這樣。
第一個被拿掉的是 llms.txt,一個放在網站根目錄、據說給 AI 看的說明檔,分母從 8 降到 7。理由一,Google 官方的 AI 最佳化指南把它列在「可以忽略的事」:不需要 LLMS.txt 這類檔案也能出現在 Google 搜尋(含生成式 AI 功能),建立它不會傷害也不會幫助排名,搜尋會忽略它(2026-09-22 查)。理由二,SE Ranking 掃了近 30 萬個網域,只有 10.13% 有這個檔案,結論是它目前不影響 AI 系統怎麼看待或引用內容;OtterlyAI 翻了 90 天的伺服器紀錄,62,100 多次 AI 機器人造訪裡只有 84 次(0.1%)打到 /llms.txt,因此把相關檢查移出自家的 GEO 稽核(皆為 2026-09-22 查)。另一家做 AI 能見度監測的工具商翻了 90 天的伺服器紀錄,62,100 多次 AI 機器人造訪裡只有 84 次(約 0.1%)打到 /llms.txt,比一般內容頁被抓的次數還少(2026-09-22 查)。(一家 AI 能見度監測工具商的 90 天伺服器紀錄實驗,2026-09-22 查)
2026-09-11 我們又拿掉 Twitter Card,分母從 9 降到 8。它管的是社群平台貼連結時那張預覽卡片,而 X 官方文件寫明解析器會回退使用既有的 Open Graph 標記(2026-09-22 查)——同一批欄位,等於同一個弱訊號在分母裡被數第二次。
我們也不拿 Archive.org(網頁歷史快照庫)的收錄狀況扣客戶的分。實測自家網域有 2019 年起的快照,但另一個架在雲端平台的站一份都沒有,用它評分站不住腳。
提醒一句:分母改過,改版前後的分數不能直接相比,看趨勢要看同一版計分表內的紀錄。目前資料庫累積了 354 份 GEO 報告、365 份 SEO 報告。
檢查表項目要能被拿掉,才叫工具;拿不掉、只會越加越多的,那是行銷素材。
為什麼 ChatGPT 查不到我的公司?
ChatGPT 查不到你的公司,原因通常是四種之一。一、網路上除了你自己的官網,沒有第三方提過你。二、官網有寫,但句子抽不出來——重點都放在圖片裡,沒有可以整段引用的事實段落。三、品牌名被斷錯詞,或跟別人同名。四、你問的方式跟客戶問的方式不一樣。
3 分鐘自己驗一次:同一天分別用「品牌名」、「品牌名+產業」、「問題型(例:台中 網站設計 推薦)」各問一次,把三種答案並排看。
開不開搜尋功能結果會不同。關掉時你看到的是模型記憶裡的舊資料,開啟時是即時抓網頁,兩種都要試,不然會誤判。最常見的誤判是只用自己登入的帳號問——歷史對話會讓 AI 比較容易講出你的品牌,看起來比實際好。
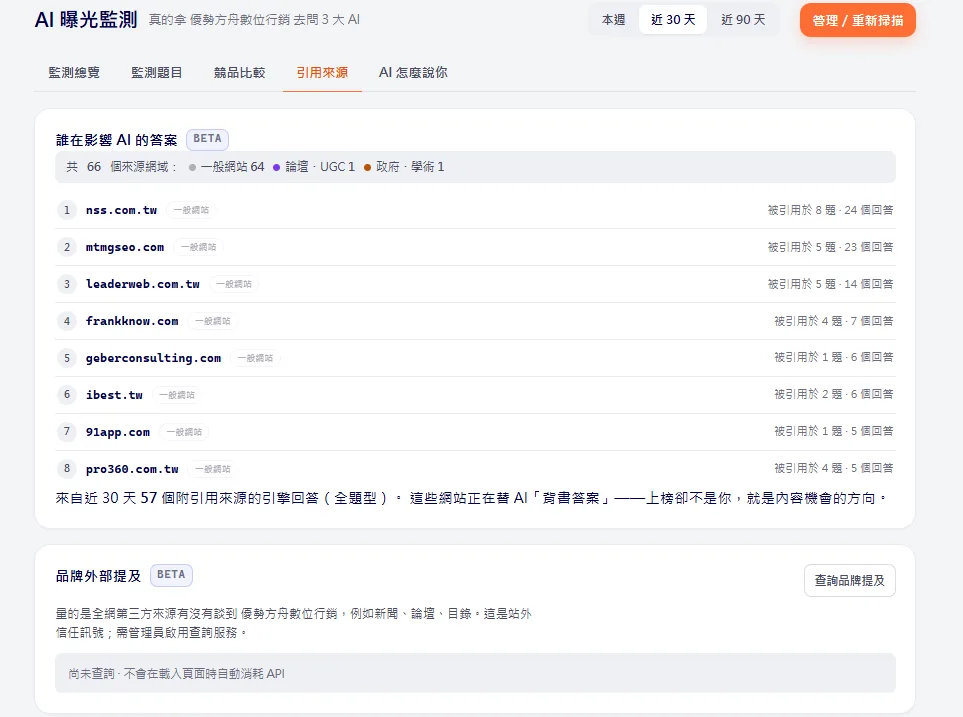
查不到不等於沒救。先看 AI 列出的來源清單裡是誰,那幾個網站就是你接下來要去露臉的地方。接著往下看第九節,那裡是純行動清單。如果連官網本身都還沒整理好,先從官網詢問單沒人填的 12 項健檢清單開始比較實在。
品牌 AI 提及率怎麼算才不會自欺?
品牌 AI 提及率是:同一題問 N 次,其中有幾次答案裡出現你的品牌名,算成比例。分子是被提到的次數,分母是總共問了幾次,兩個數字都要寫進表格,只報一個百分比等於沒報。
有客戶問過我一句原話:「這我自己問 ChatGPT 不就好了?」問一次是感覺,跑成比例才是數據。模型每次回答本來就有隨機性,單次結果好壞都不能當結論。
污染源要先關掉,不然數字是假的:
- 登入狀態與記憶功能——一律用無痕視窗或 API,關掉記憶
- 瀏覽紀錄與地區設定——固定同一個地區
- 有沒有開啟搜尋功能——開與關要分成兩組紀錄
抓取時還要同時比對全名、簡稱、英文名,以及可能被寫成簡化字的版本,不然明明被提到卻漏記。最後,固定三件事才有比較意義:同一批提示詞、同一組設定、同一個週期(例如每週三下午)。任何一項改了,要在表上註明。
沒有預算,怎麼自己做一套每週監測?
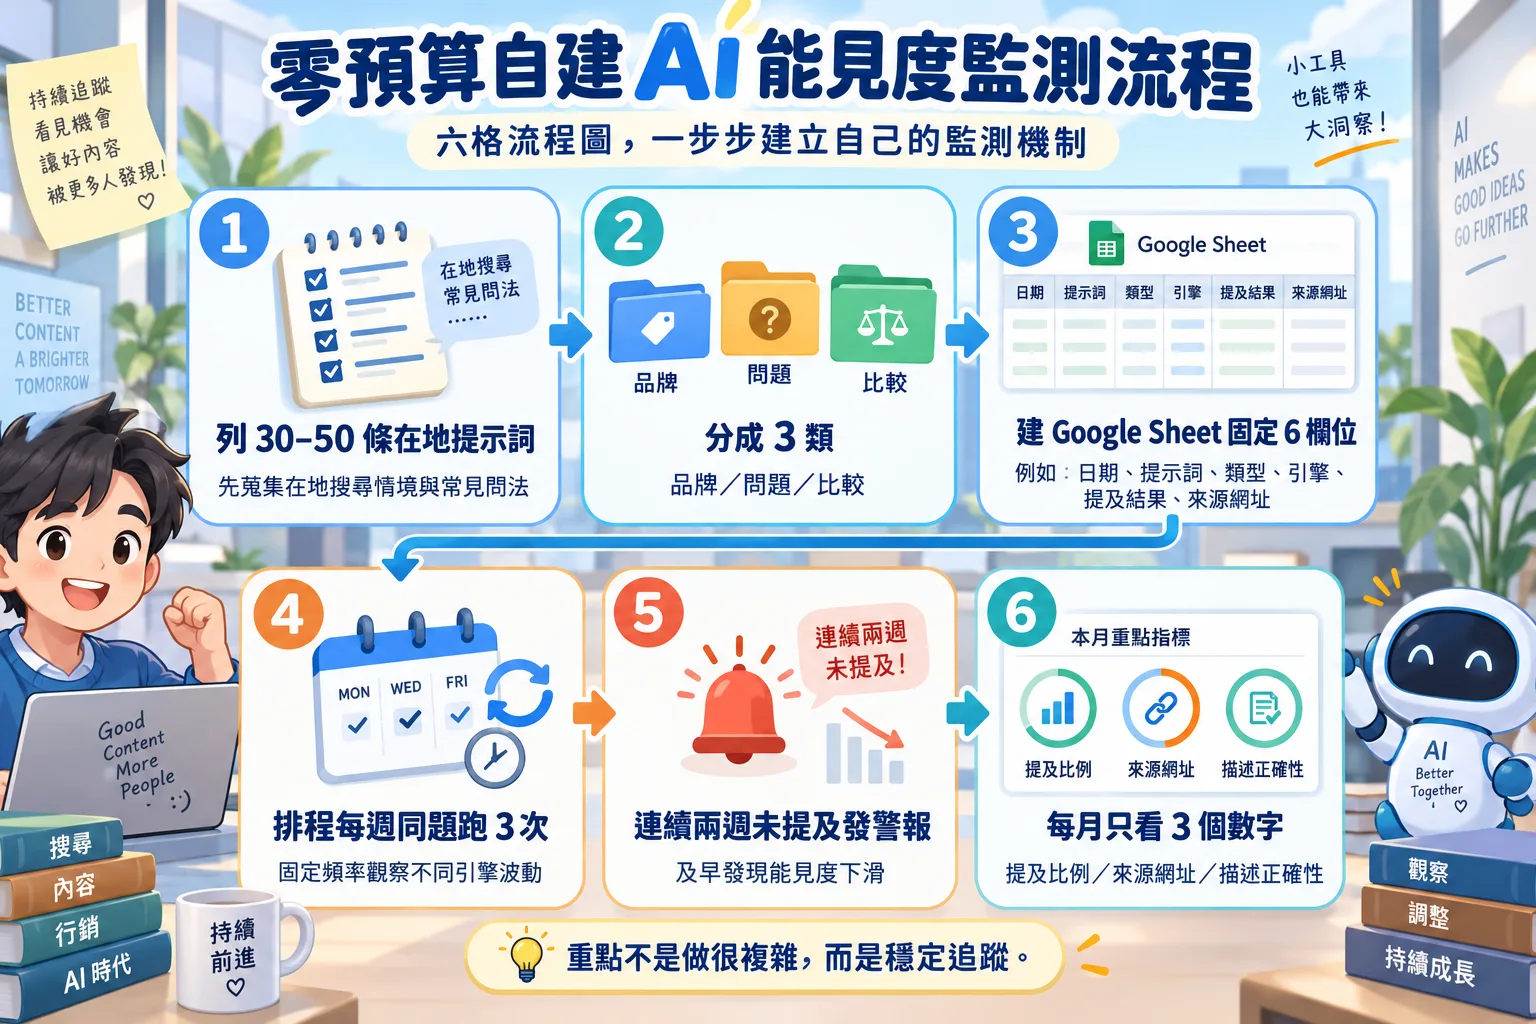
零預算的做法是六個步驟,一個下午就能建起來:
- 列 30 到 50 條台灣人真的會打的提示詞,含「推薦」「台中」「費用」「哪一家」「ptt」這些在地詞。
- 把提示詞分三類:品牌詞、產業問題型、比較型。
- 建一張 Google Sheet,欄位固定為日期、引擎、提示詞、有無提及、出現在第幾句、AI 列出的來源網址。
- 排一個 AI Agent(會照腳本自己去跑的程式)每週同一天跑一輪,一律無痕、關記憶,同一題跑 3 次取比例。
- 設一條警報規則:同一題連續兩週沒被提及,就發 LINE 通知,其餘時間不用看。
- 每月看一次趨勢,只看三個數字——提及比例、來源清單有沒有出現你的網址、描述有沒有講錯。
判讀門檻先訂好,週報才不會變成看心安的。我們的建議是:核心題的提及比例連續四週沒有變化,就代表這一招沒效,換題目或換露臉的管道,不要只是繼續跑。排程那一段如果不知道從哪開始,中小企業 AI 自動化從哪裡開始那篇有排序方法。
測出來能見度是 0,下一步該做什麼?
能見度 0 不是一種病,是三種症狀,對應的動作完全不同。先對照下表找到自己那一列,這週只做一件事。
| 症狀 | 可能缺什麼 | 這週先做哪一件 |
|---|---|---|
| 完全沒被提到 | 缺第三方提及與清單型文章 | 去 AI 引用來源裡已經出現的那幾個媒體、產業目錄、論壇露臉 |
| 被提到但描述錯誤 | 官網缺可被引用的事實段落與 Schema(給機器看的資料標籤) | 在關於我們與服務頁補一段一句一事實的敘述 |
| 被提到但排在同業後面 | 缺比較型內容與具名案例 | 寫「A 方案與 B 方案怎麼選」這類頁面,附可查證的案例 |
每個動作都要配一個驗收方式:下一次掃描時,那一題的提及比例有沒有動、來源清單有沒有換人。沒動就換題目重測,不要直接加預算。
誰做?第一列是公關與內容的工作,第二列改官網文案自己就能動,第三列需要一個寫得出比較文的人。三列不要同時開,一個月推一件,你才分得出來是哪一件有效。想看實際長相可以翻我們的成功案例。
GEO 監測工具月費大概多少?要不要綁年約?
GEO 監測工具的月費差距很大,而且多數台灣服務商沒有公開價目表,所以我不打算憑印象生一張市場行情表給你。國際工具這一端有公開定價可以對照:Otterly.AI 官方定價頁列出 Lite 方案每月 29 美元、含 15 組提示詞,Standard 每月 189 美元、100 組提示詞,Premium 每月 489 美元、400 組提示詞(查詢日期 2026-09-22)。換句話說,這類工具的價格單位其實是「你要監測幾題提示詞」,而不是「有沒有儀表板」。另外 Google Gemini、Google AI Mode 這些引擎在該頁是另外加購的,報價時要問清楚引擎含幾個。(Otterly.AI 官方定價頁,2026-09-22 查)
查到彼此矛盾反而是好事,那通常就是這題的切角。同樣叫「AI 能見度監測」,一邊賣的是每月一次的報告,一邊賣的是每天更新的儀表板,價格本來就不能直接比。比價之前先問清楚:買的是幾個引擎、幾題提示詞、跑幾次。
節奏上,中小企業每月看一次就夠。每天更新的儀表板多付的是刷新頻率,不是決策品質——提示詞跟內容一個月改不了幾次,天天看只會看到隨機性。
我們自家的區間放在最後,角色是「一個有人負責的起點」,不是市場平均,也不承諾固定價格。我們自己的收費落在每月 NT$990 到 1,490 之間——年繳攤下來最低、月繳最高,含每月 150 次實際查詢。沒有綁約,年繳有 14 天無條件退款。
放這個區間不是要你買,是讓前面那些「市場行情」有個對照:這是一個實際在收錢、也實際有人要負責回答「為什麼這個月分數掉了」的價格帶。比這低很多的通常是純自動化報表,比這高很多的通常包含顧問工時。
完整方案可以看方案費用頁。
國外訂閱工具在繁中場景有哪些死角?最常犯的錯是什麼?
國外訂閱工具在繁中場景有三個死角:提示詞庫多半是英文語料翻過來的、台灣在地問法(「台中」「推薦」「ptt」「哪一家」)覆蓋不到、繁中回答裡品牌名被切開導致比對時漏記。
你會在比較文裡看到 Profound、Otterly、Peec、SE Ranking 這些名字。我不能憑感覺評它們的優劣——
限制也先自己講:同一把尺量日文站、英文站與繁中站本來就會有落差,引用來源的結構不同(英文站多媒體與論壇,繁中站常混入部落格與社群),跨語言的分數不要直接比大小。
最常犯的四個錯:只看總分不看分項;同一題只跑一次;把三個引擎合併成一張圖;把 llms.txt 這種沒有證據的項目排在待辦清單第一名。還有一個判斷報告好壞的簡單方法——如果一份報告裡沒有任何一句 AI 的原始回答、也沒有來源網址,那份報告沒辦法驗,看了也不知道要改什麼。想少走冤枉路,AI 自動化導入失敗的 4 個實況那篇也可以一起看。
常見問題
免費的 AI 能見度檢查工具夠用嗎?
免費的 AI 能見度監測工具,如果只要你貼網址、然後給一個 0 到 100 的分數,那量的是你網頁寫得好不好,不是 AI 講不講你。當入門自我檢查可以,但要看提及狀況,還是得有實際去問模型的紀錄與來源網址。
ChatGPT 查不到我的公司,多久才會被查到?
老實說沒有可以承諾的時間,那取決於網路上有多少第三方提到你、以及模型多久更新一次。務實做法是每月固定掃一次,看提及比例與引用來源有沒有變化,用趨勢判斷而不是憑感覺。
品牌 AI 提及率要跑幾次才算數據?
同一題只問一次沒有意義,模型回答本身有隨機性。至少同題跑 3 次取比例,並且固定用無痕、關掉記憶,每次都用同一批提示詞,這樣前後兩個月才比得起來。
llms.txt 到底要不要做?
我們已經把它從 GEO 計分裡拿掉,分母從 8 降到 7。Google 官方的 AI 最佳化指南明說它不影響 Google 搜尋與生成式 AI 功能,SE Ranking 與 OtterlyAI 的紀錄稽核也沒測到主流 AI 去讀它。想放可以放,但不要排在待辦清單前面。
我該監測幾個 AI 引擎?
我們只跑 ChatGPT、Claude、Gemini 三個,不做 Perplexity 和 Grok。與其列五個名字但抽樣跑,不如三個每次都真的跑完,而且三個引擎的引用來源差很多,要分開看。
想知道你現在被 AI 講成什麼樣子?
挑 AI 能見度監測工具之前,先跑一次AI 能見度檢測,看報告裡有沒有列出 AI 的原始回答與來源網址——這兩樣才是能拿去改東西的東西。想把監測、官網改寫與內容排程一起處理,直接跟我們聊聊你的情況;平常的實測紀錄都放在行銷部落格。